


Absent
L'IA ne te cite pas
Tu n'existes pas dans la conversation d'achat. Ton concurrent, si.

Guide GEO · mis à jour octobre 2026
En 2025, 76 % des pages citées par les IA venaient du top 10 Google. Un an plus tard : 38 %. Être premier sur Google ne garantit plus d'exister dans ChatGPT. Voilà la méthode complète pour mesurer ta place dans les réponses IA, et la reprendre : du cadrage à la mesure du trafic IA, avec les vrais chiffres de nos audits.
×5,8
de trafic IA en un an sur un cas réel, méthode appliquée
2 527
recherches IA analysées sur un seul audit
21
contrôles techniques d'accessibilité IA, testables gratuitement

La réponse courte
Un audit GEO mesure, axe par axe, si une marque est absente, mentionnée ou recommandée dans les réponses des assistants IA (ChatGPT, Gemini, Perplexity), puis explique pourquoi.
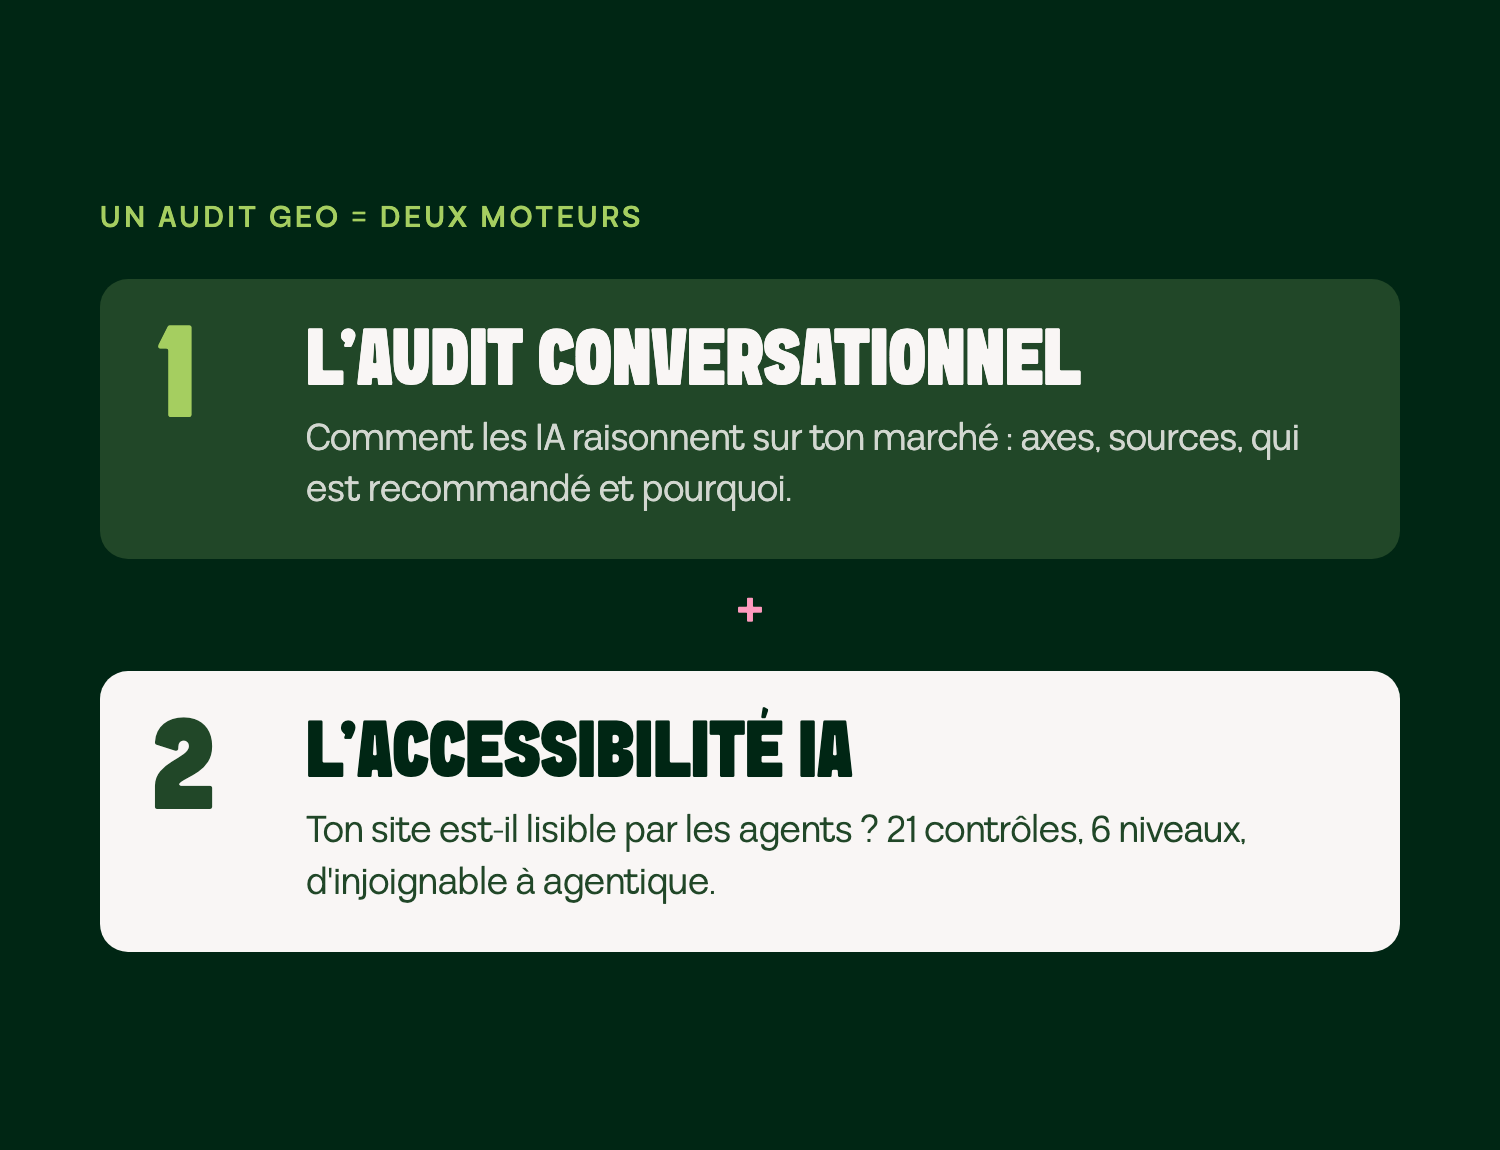
Il croise deux moteurs : l'analyse conversationnelle (comment l'IA arbitre sur ton marché) et l'accessibilité IA (ton site est-il lisible par les agents). La méthode tient en 8 étapes et 3 semaines :
Le cadrage : une marque, une gamme
Les conversations IA à grande échelle
Les axes décisionnels
Les sources de confiance : découverte et couverture
Le scoring face aux concurrents réels
L'accessibilité IA (21 contrôles)
Le plan d'action : quatre chantiers priorisés, le texte à publier déjà rédigé
La mesure du trafic IA
La méthode en vidéo
Comment on a fait de ChatGPT notre premier levier d'acquisition en 3 mois : Franck Neuenschwander, CEO de Botanik, déroule l'audit étape par étape. Pourquoi on a arrêté le prompt tracking, ce que l'analyse conversationnelle trouve vraiment, les KPI suivis après l'audit, et les résultats de Botanik et d'un constructeur automobile. 19 chapitres : va directement à l'étape qui t'intéresse.
Il y a un an, un bon ranking Google te donnait deux citations IA sur trois. Aujourd'hui, une sur trois. Le SEO et le GEO ont divorcé, et la plupart des marques ne l'ont pas remarqué, parce que personne ne mesure.
Un e-commerçant de matériel électrique, persuadé d'être bien placé : mentionné dans 20 % des réponses IA, recommandé dans 0 %, absent de 80 %. Même quand l'IA le citait, elle n'a jamais dit « je vous conseille celui-là ». L'audit te dit dans quelle case tu es, axe par axe.
Absent
L'IA ne te cite pas
Tu n'existes pas dans la conversation d'achat. Ton concurrent, si.
Mentionné
Cité, sans préférence
Tu es dans la liste, mais l'IA ne pousse pas vers toi. Choix secondaire, trafic faible.
Recommandé
L'option à retenir
L'IA te présente comme le bon choix. C'est là que partent le trafic et les leads.
La mécanique
L'audit conversationnel : comprendre comment les IA raisonnent sur ton marché. Quels critères déclenchent une recommandation, quelles sources font foi, qui est recommandé aujourd'hui et pourquoi.
L'audit d'accessibilité IA : vérifier que ton site est techniquement lisible par les agents. Tu peux être la meilleure réponse du marché : si les bots IA ne peuvent pas te lire, tu n'existes pas.
Les deux sont cumulatifs. Un contenu parfait sur un site illisible ne sert à rien ; un site parfaitement accessible qui ne couvre aucun axe décisionnel non plus.
Un aveu : on a commencé, comme tout le monde, par le prompt tracking. Des questions envoyées par API, un compteur de citations, un joli graphique. Mais j'ai passé quinze ans côté annonceur : une data que je ne peux pas prouver, je ne la présente pas. Et celle-là, je ne pouvais pas.
Impossible d'anticiper ce que tes clients tapent vraiment. La moindre variation de formulation change la réponse : cinquante prompts choisis à la main ne représentent personne.
La plupart des outils interrogent les modèles par API : modèle souvent différent, contexte épuré, compte vierge. Tes clients, eux, ont un historique et une personnalisation. Tu mesures un signal que personne ne voit.
Savoir si tu es cité ne dit ni pourquoi, ni quoi corriger. L'analyse conversationnelle remonte les critères et les sources qui font basculer la recommandation.
8 étapes, 3 semaines d'audit
Un an après · constructeur automobile
×5,8trafic IA
de 461 à 2 694 sessions IA par mois
01 → 04
Le diagnostic
01 Cadrage : marque, secteur, périmètre, une seule gamme par audit. Et ton trafic IA de départ, section par section.
02 Conversations IA : des agents dialoguent en multi-tours avec les assistants, comme de vrais acheteurs, avec Oracle.
03 Axes décisionnels : les critères sur lesquels l'IA arbitre ton marché.
04 Sources de confiance : où l'IA repère les marques (Reddit, Wikipédia, comparateurs), et où elle vérifie chaque axe.
Semaine 1
05 → 06
Le verdict
05 Scoring : recommandé, mentionné ou absent, axe par axe, face aux concurrents que l'IA détecte elle-même.
06 Accessibilité IA : 21 contrôles techniques, un niveau de 0 à 5, l'écart avec tes concurrents.
Semaine 2
07
La restitution
07 Plan d'action : quatre chantiers priorisés, un par pilier. Pour chaque axe manquant, la page exacte à enrichir et le texte à publier, déjà rédigé. Restitué de vive voix.
Semaine 3
08
Le suivi
08 Mesure : trafic IA et accessibilité IA chaque mois dans ton reporting, re-audit chaque trimestre.
Chez un constructeur automobile : ×5,8 de trafic IA en un an.
Mois 1 à 12
Le niveau 1 est la seule vraie porte : un bot bloqué au pare-feu rend tout le reste inutile. Au-dessus, le niveau affiché est le plus haut palier atteint, et chaque palier manquant en dessous est un trou à combler en premier.
| Niveau | Nom | Ce qui est vérifié | Ce que ça change |
|---|---|---|---|
| 0 | Injoignable | Pare-feu ou robots.txt qui bloque les bots IA | Rien d'autre ne compte : c'est à corriger d'abord |
| 1 | Joignable | Page d'accueil accessible, robots.txt ouvert aux bots IA | La seule vraie porte |
| 2 | Politique IA déclarée | Bots IA nommés et autorisés, Content Signals | Tu dis aux IA ce qu'elles ont le droit de faire |
| 3 | Lisible agents | llms.txt, contenu servi en markdown, Link headers | Les LLM lisent ton contenu sans les fioritures |
| 4 | Connecté | APIs et authentification découvrables | Un agent peut se brancher sur ton service |
| 5 | Agentique | MCP, A2A, commerce agentique | Un agent peut agir et acheter chez toi |
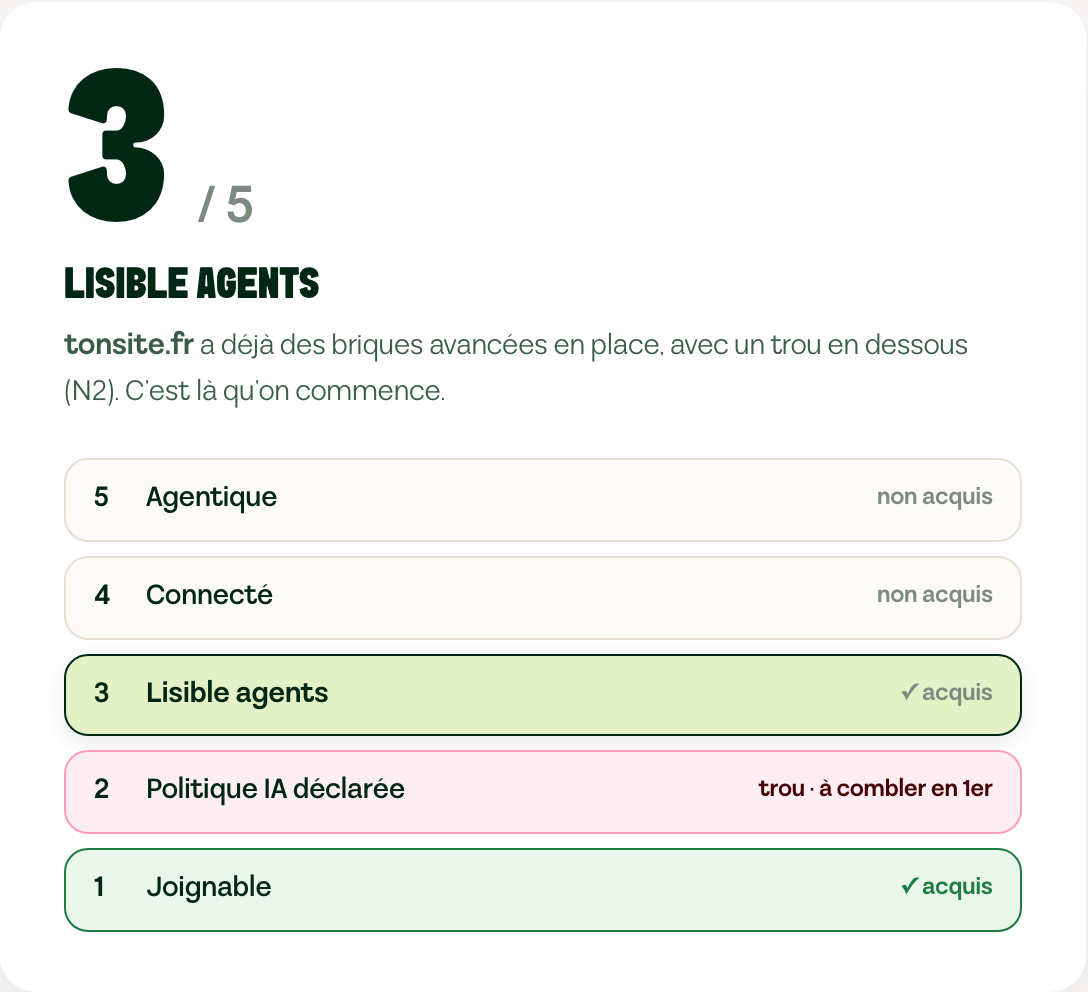
L'étape 6 en vrai
Le scan rend un verdict sur 5 en une trentaine de secondes, palier par palier. Dans cet exemple, un site déjà « lisible agents » (niveau 3) avec un trou au niveau 2 : aucune politique IA déclarée.
Un site qui saute un palier reste fragile. On comble ce trou d'abord, le reste est déjà en place.
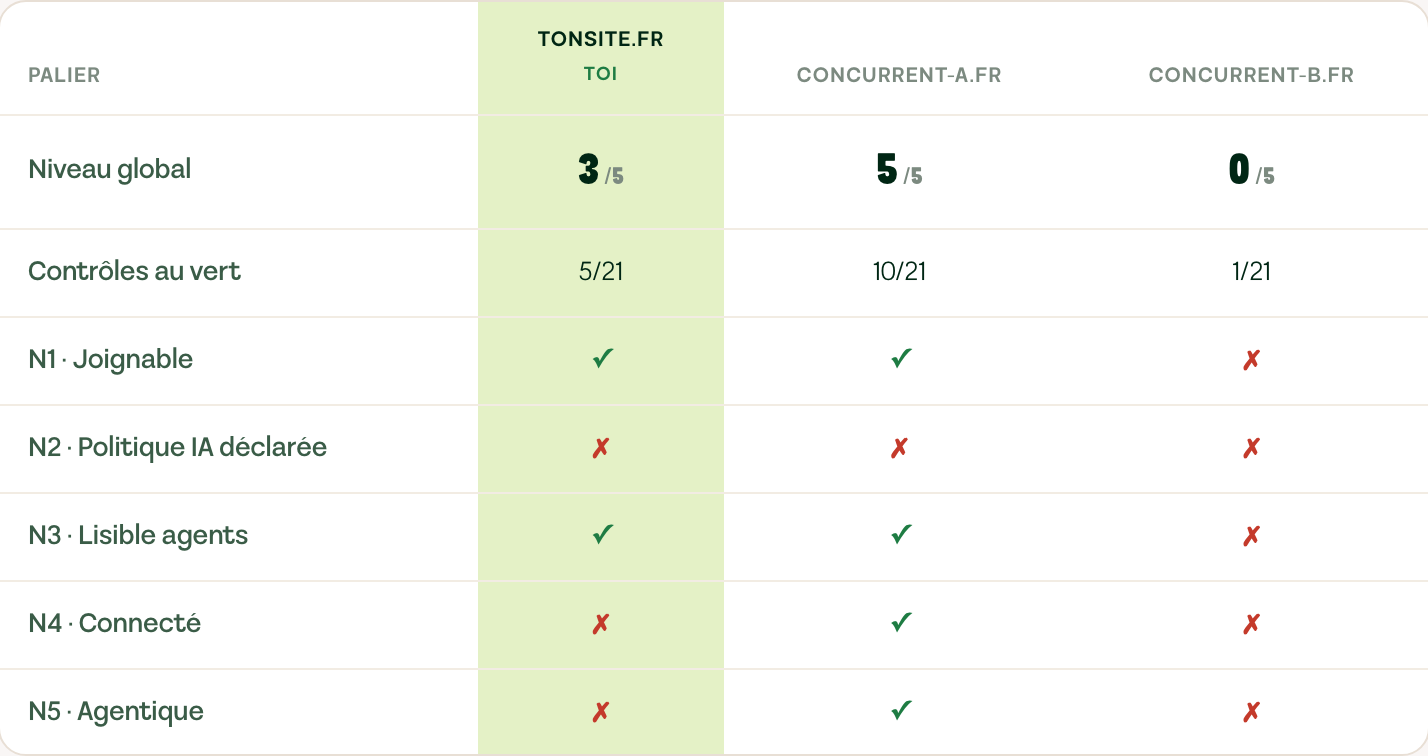
Face à tes concurrents
Jusqu'à trois concurrents, scannés pour de vrai avec les mêmes 21 contrôles. Ici (domaines masqués), un concurrent est déjà agentique, un autre injoignable : deux écarts qui ne se voient dans aucun outil SEO.
Ton rapport affiche les vrais domaines, et la matrice des 21 contrôles site par site.
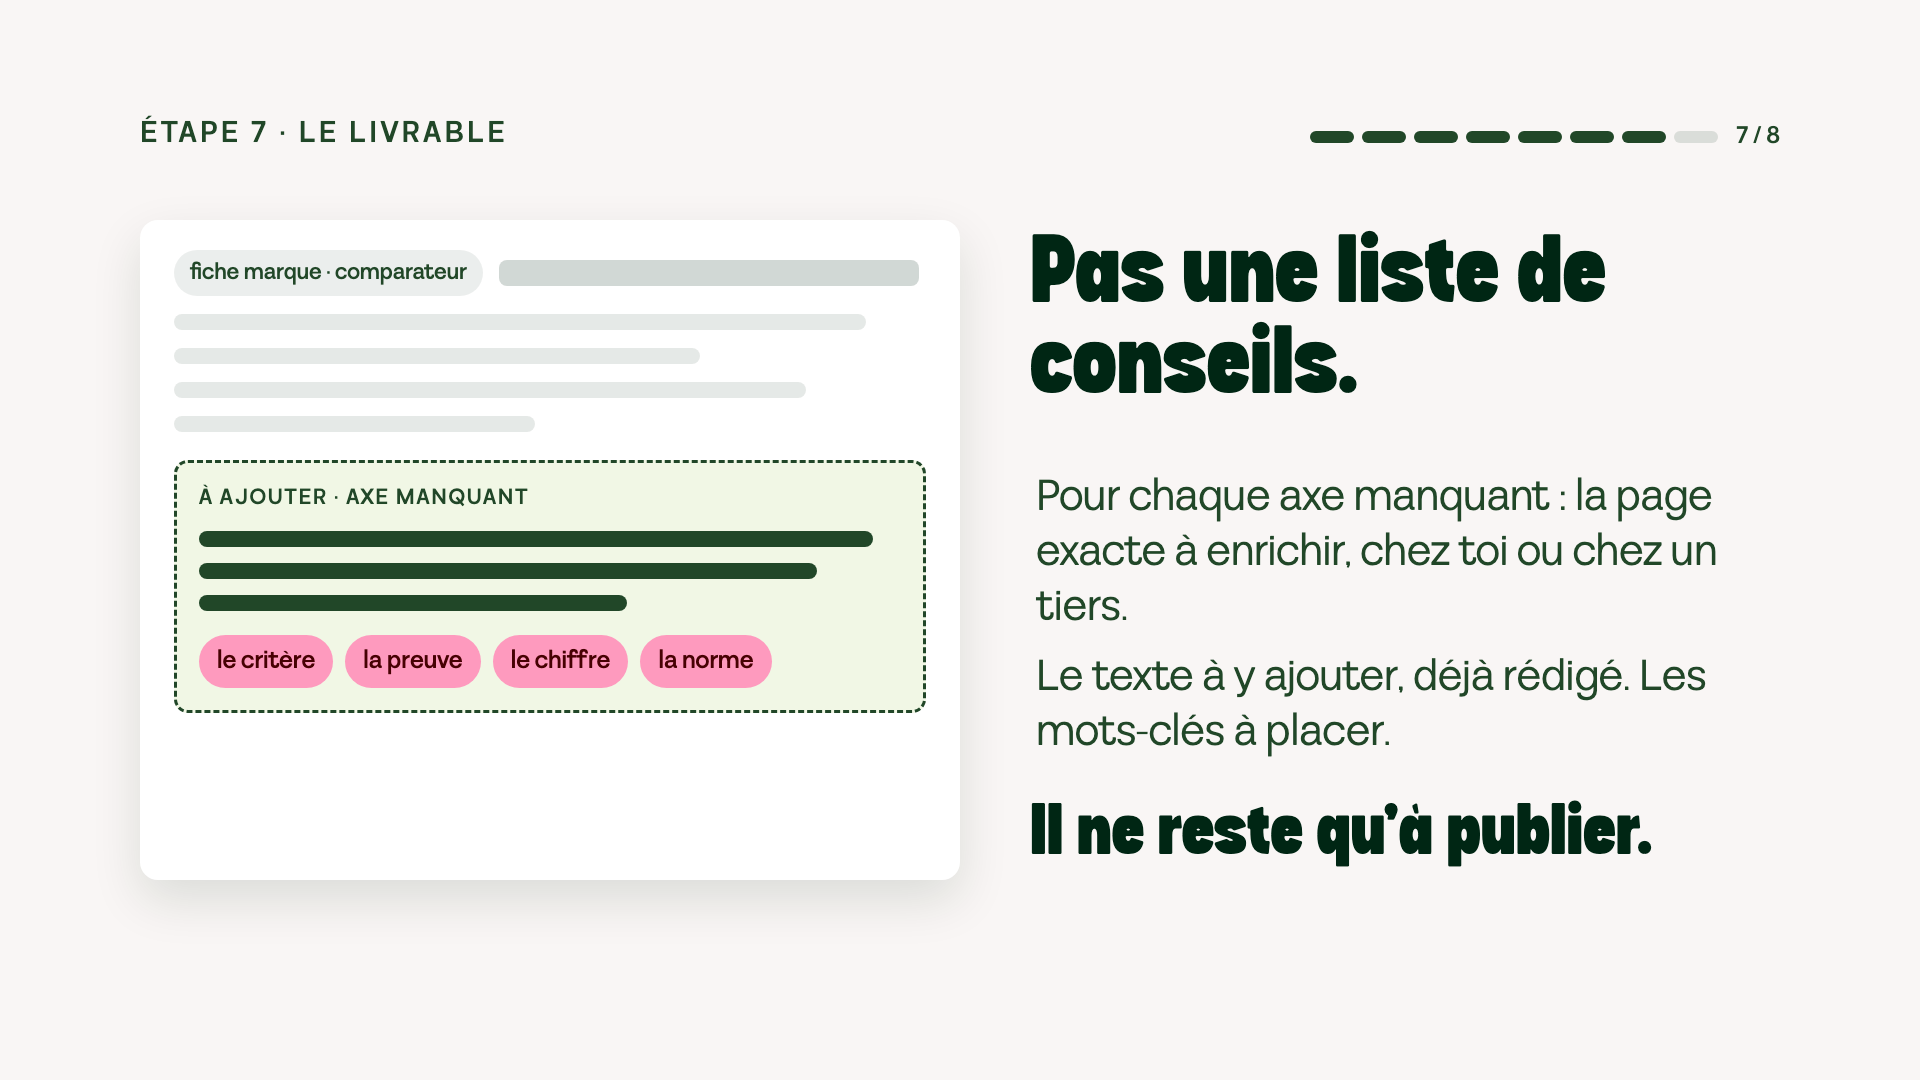
L'étape 7 en vrai
Un chantier par pilier, chacun avec sa priorité (haute, moyenne ou basse) selon ce que l'audit a trouvé :
Ton site : couvrir chaque axe manquant, page par page. Une question posée à l'IA en déclenche des dizaines (le fan-out) ; la page doit y répondre, et les données structurées prennent les questions techniques.
Les sources de découverte : obtenir des mentions là où l'IA repère les marques qui existent : Reddit, Wikipédia, Wikidata.
Les sources de couverture : là où elle vérifie chaque axe : comparateurs, sites d'avis, médias spécialisés. Communiqués de presse à bas coût et articles invités sur des sites d'autorité servent d'accélérateur.
L'accessibilité IA : du plus simple (robots.txt, sitemap, llms.txt) au plus poussé (markdown, commerce agentique), trou par trou.
Et le livrable n'est pas une liste de conseils. Pour chaque axe manquant : la page exacte à enrichir, chez toi ou chez un tiers, le texte à y ajouter, déjà rédigé, et les mots-clés à placer. Il ne reste qu'à publier.
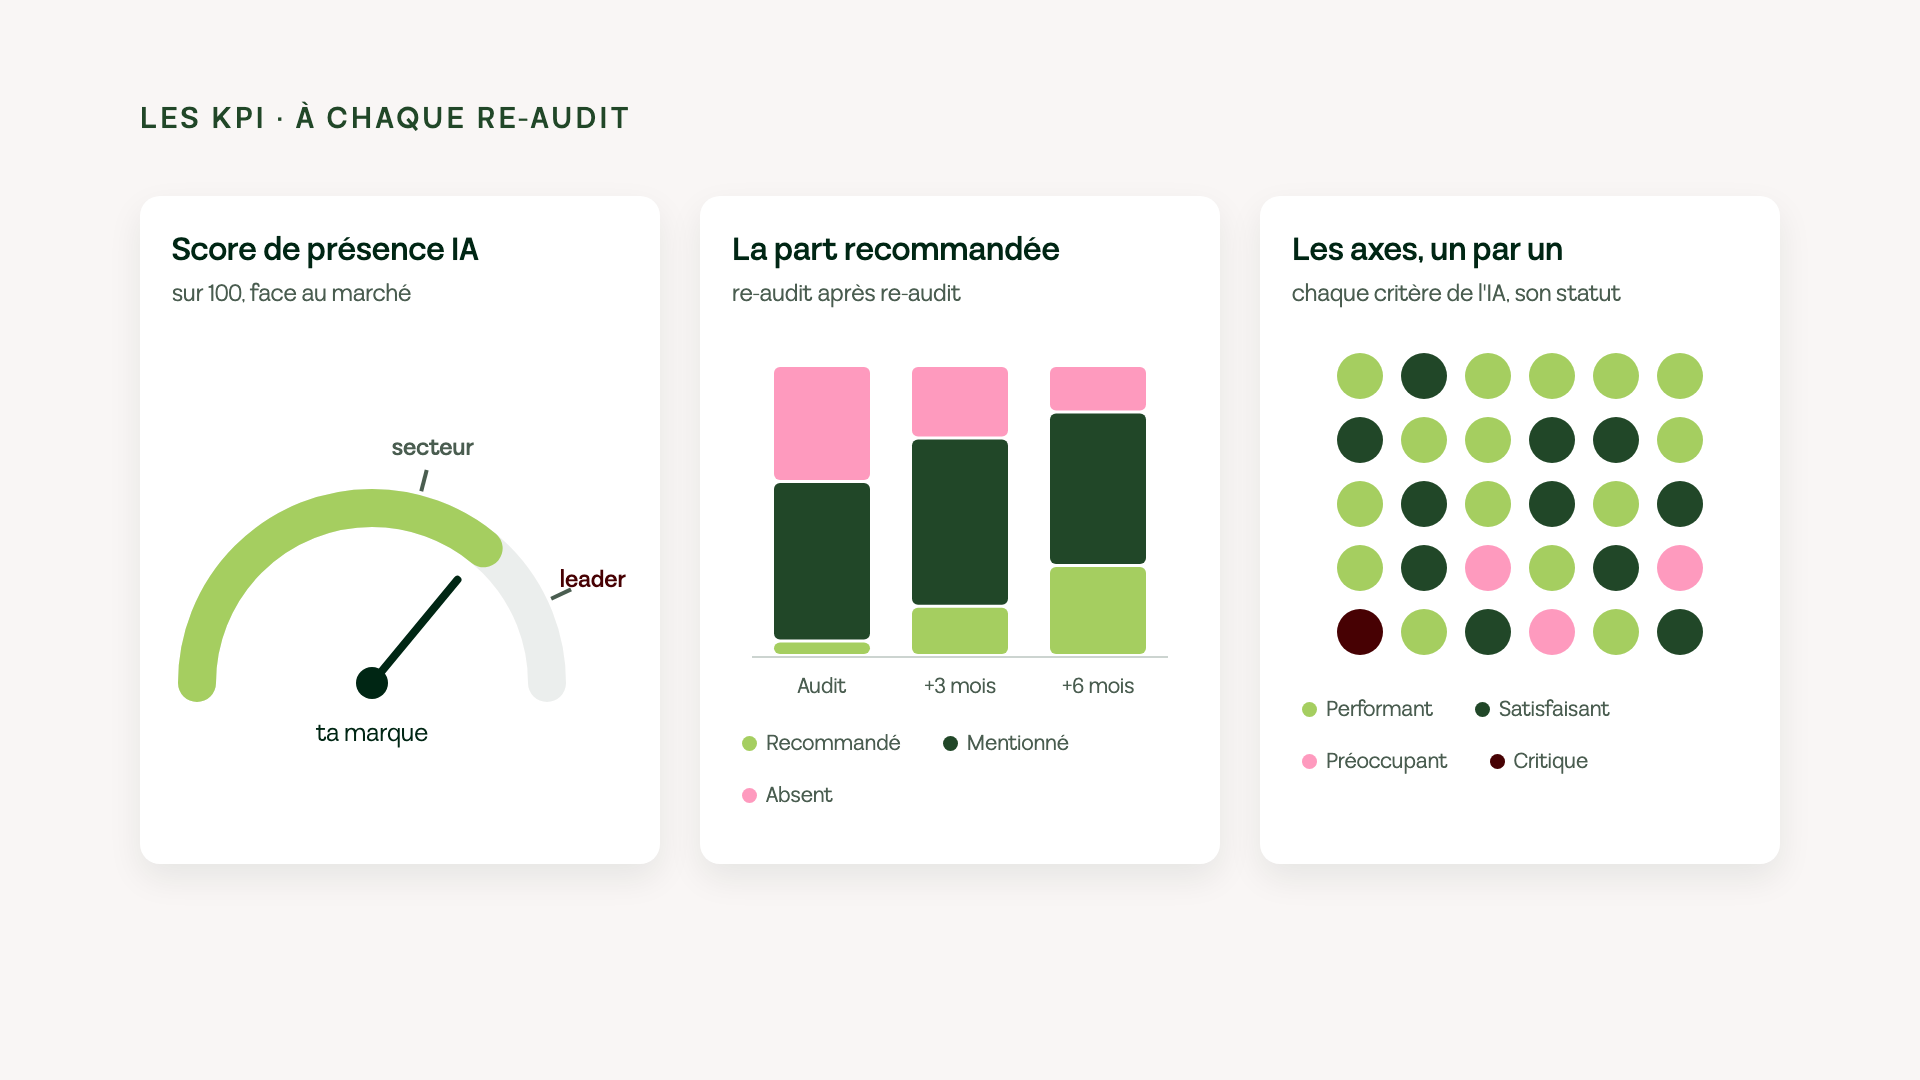
Après l'audit · à chaque re-audit
Ils sortent de l'audit conversationnel, et on les relève à chaque re-audit, en général chaque trimestre.
Le score de présence IA, sur 100, lu face à la moyenne du secteur et au leader de ta catégorie.
La part recommandée. Recommandé, mentionné ou absent : un bon score de présence peut cacher une marque surtout mentionnée. C'est la part recommandée qu'on fait monter, re-audit après re-audit.
Les axes décisionnels, un par un : performant, satisfaisant, préoccupant ou critique. Les préoccupants deviennent la liste de travail du trimestre.
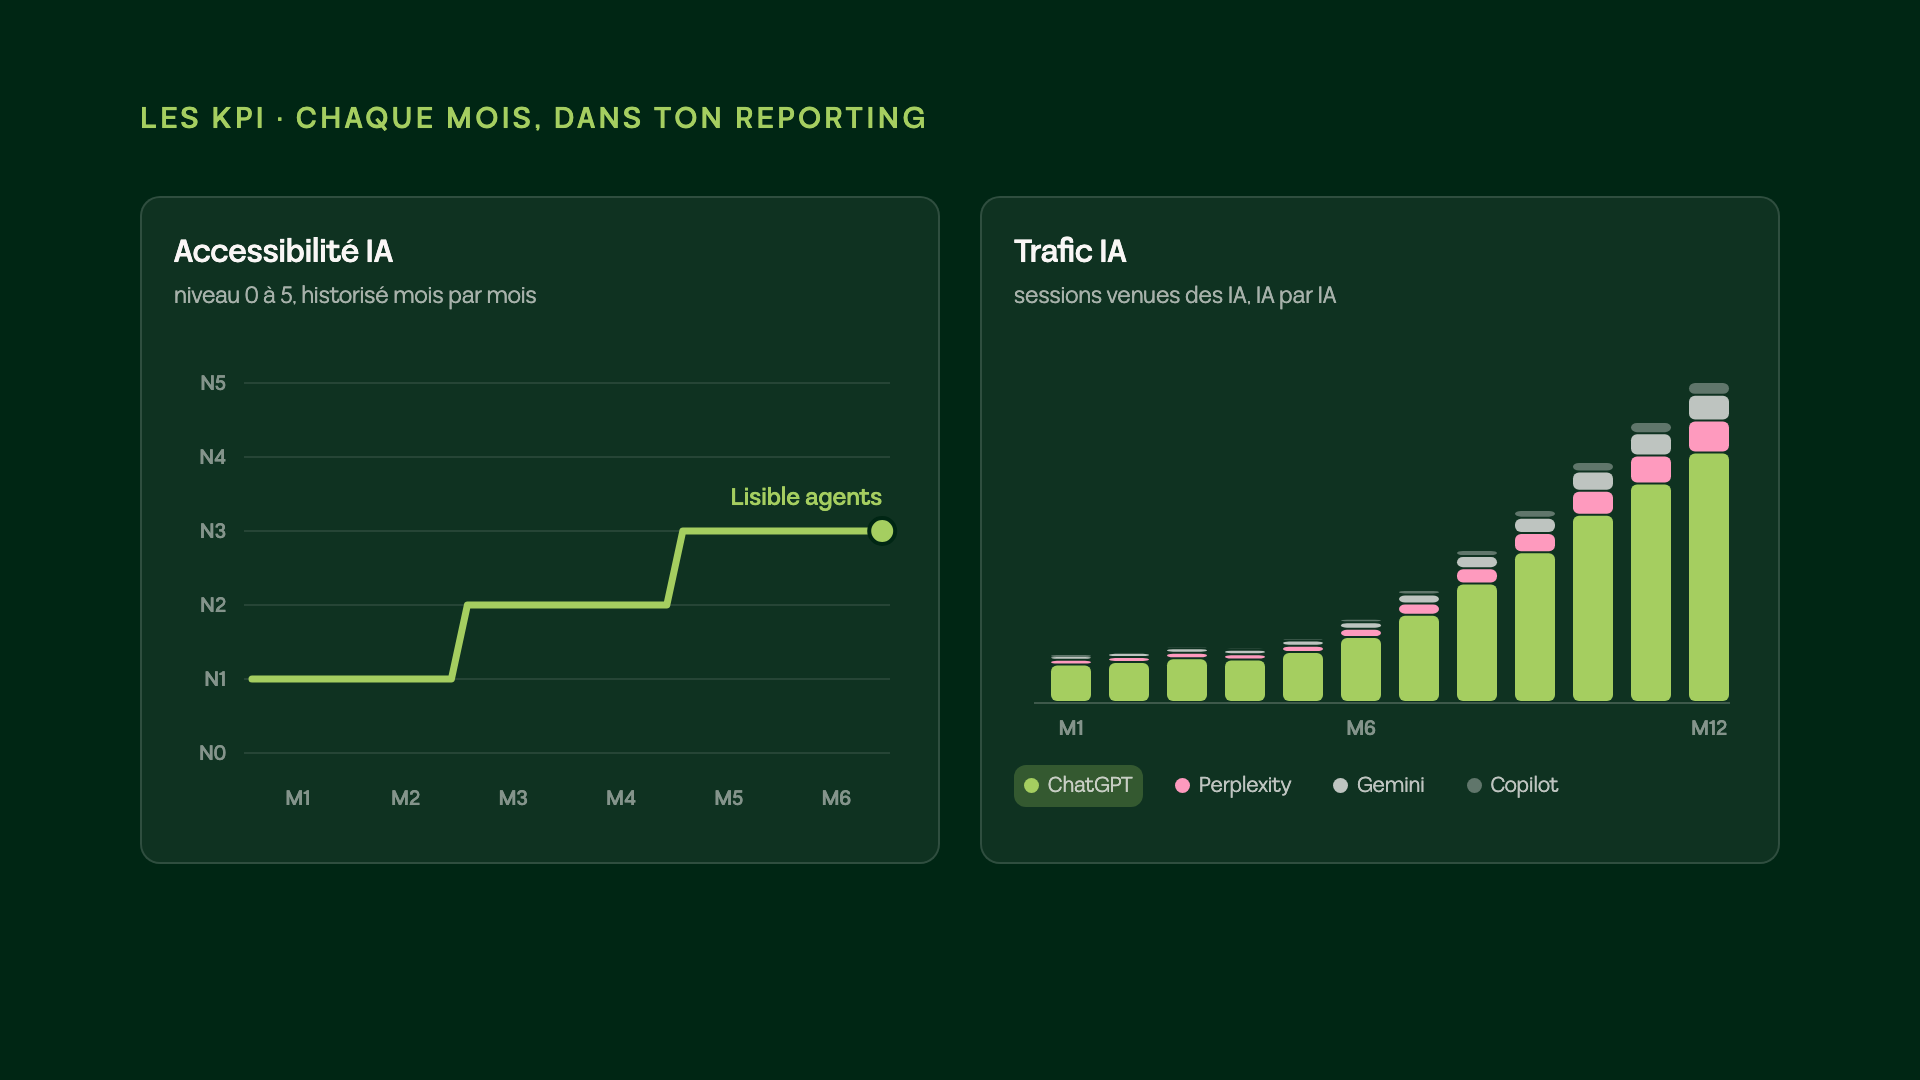
Après l'audit · chaque mois
L'accessibilité IA : les 21 contrôles relancés à chaque reporting, le niveau de 0 à 5 historisé. Tu vois le palier gagné, et celui qui manque encore.
Le trafic IA : les sessions venues de ChatGPT, Perplexity, Gemini ou Copilot, IA par IA, avec les conversions quand ton analytics les suit. C'est le KPI qui dit si le reste marche.
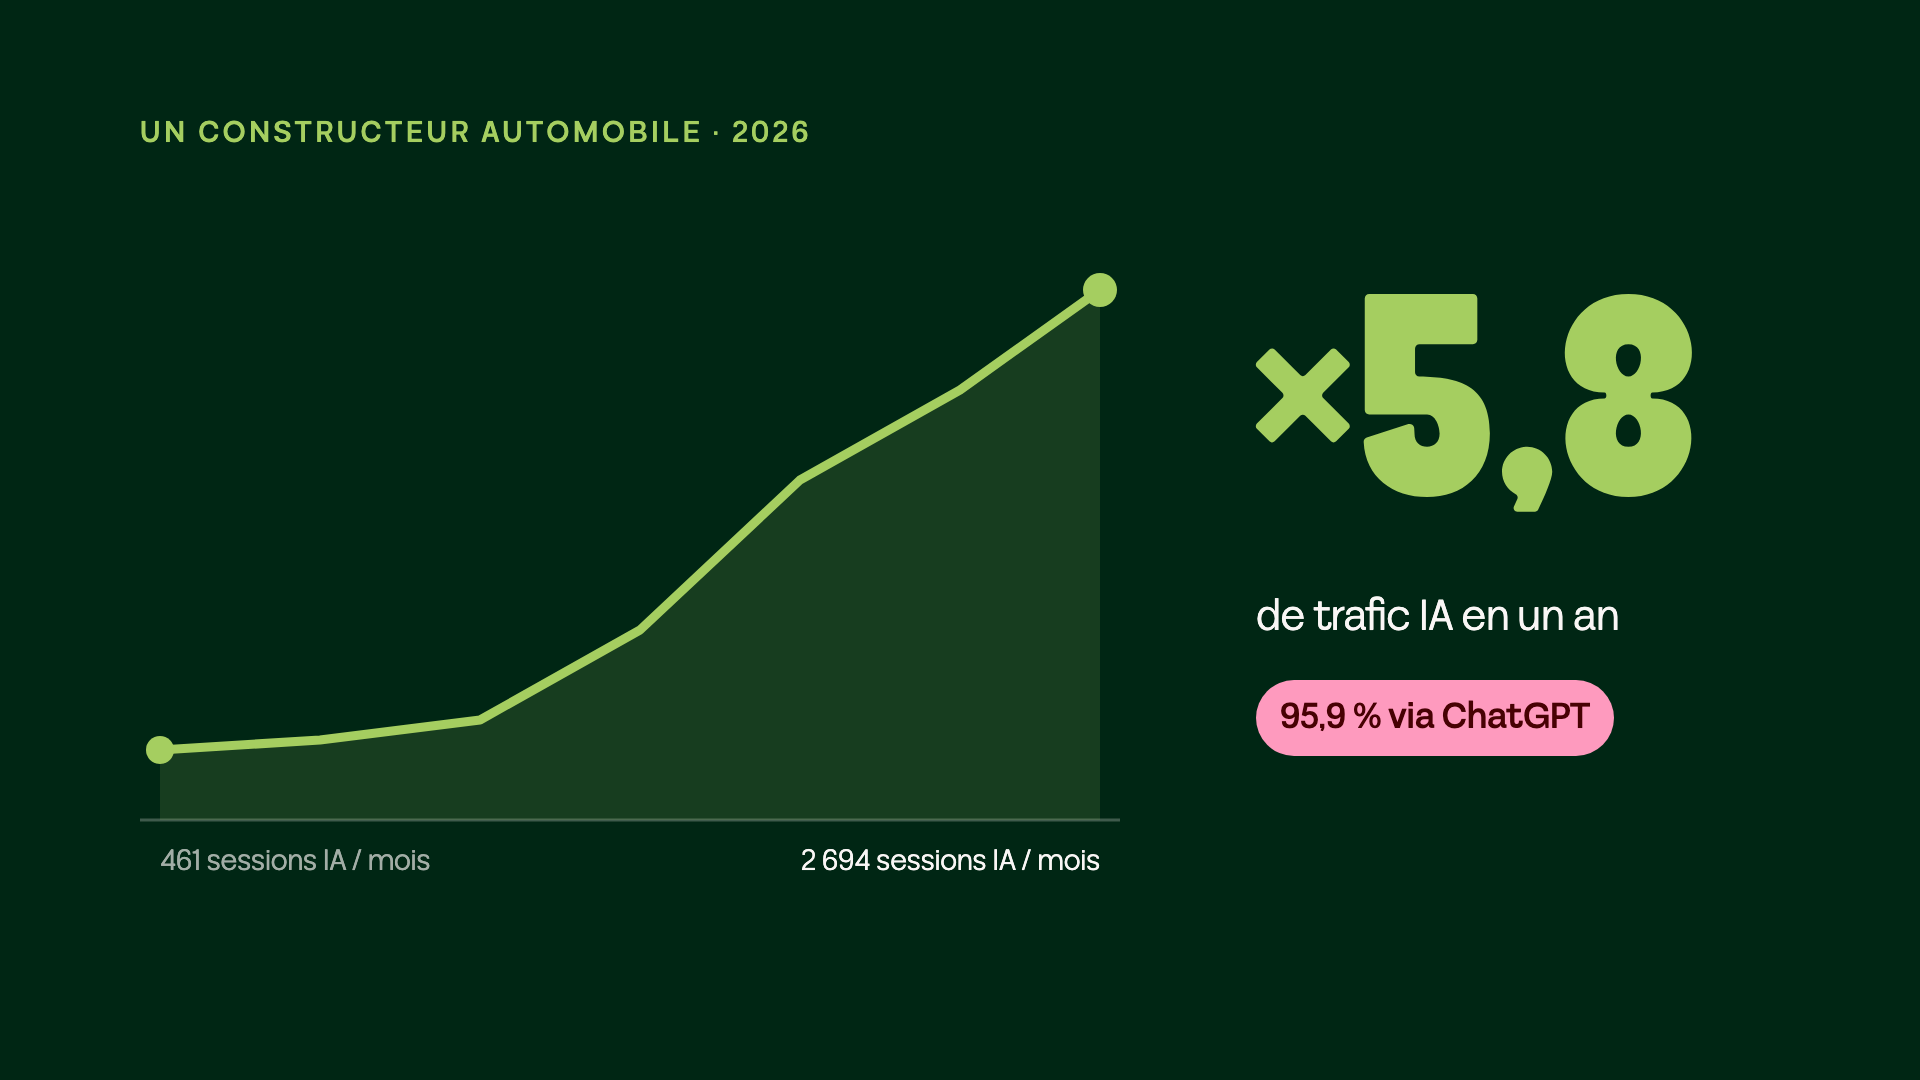
Use case · constructeur automobile
Un constructeur automobile (on ne peut pas le nommer) a déroulé cette méthode sur une gamme : audit conversationnel au printemps, 2 527 recherches, 30 axes, 20 sources de confiance dont 5 où il était absent. Puis le plan d'action : sémantique et netlinking sur les sources IA.
Deux mois après la mise en production, la courbe décolle. Un an après : de 461 à 2 694 sessions IA par mois, dont 95,9 % via ChatGPT. Sur la page clé de la gamme, les clics Google passent de 573 à 24 895 : le contenu qui couvre un axe décisionnel sert les deux moteurs.
Les réserves, parce qu'on les donne toujours : une partie du gain vient d'une demande créée par un dispositif public cette année-là, et 2 694 sessions par mois restent petites face au SEO du même site. Le point, c'est la pente.
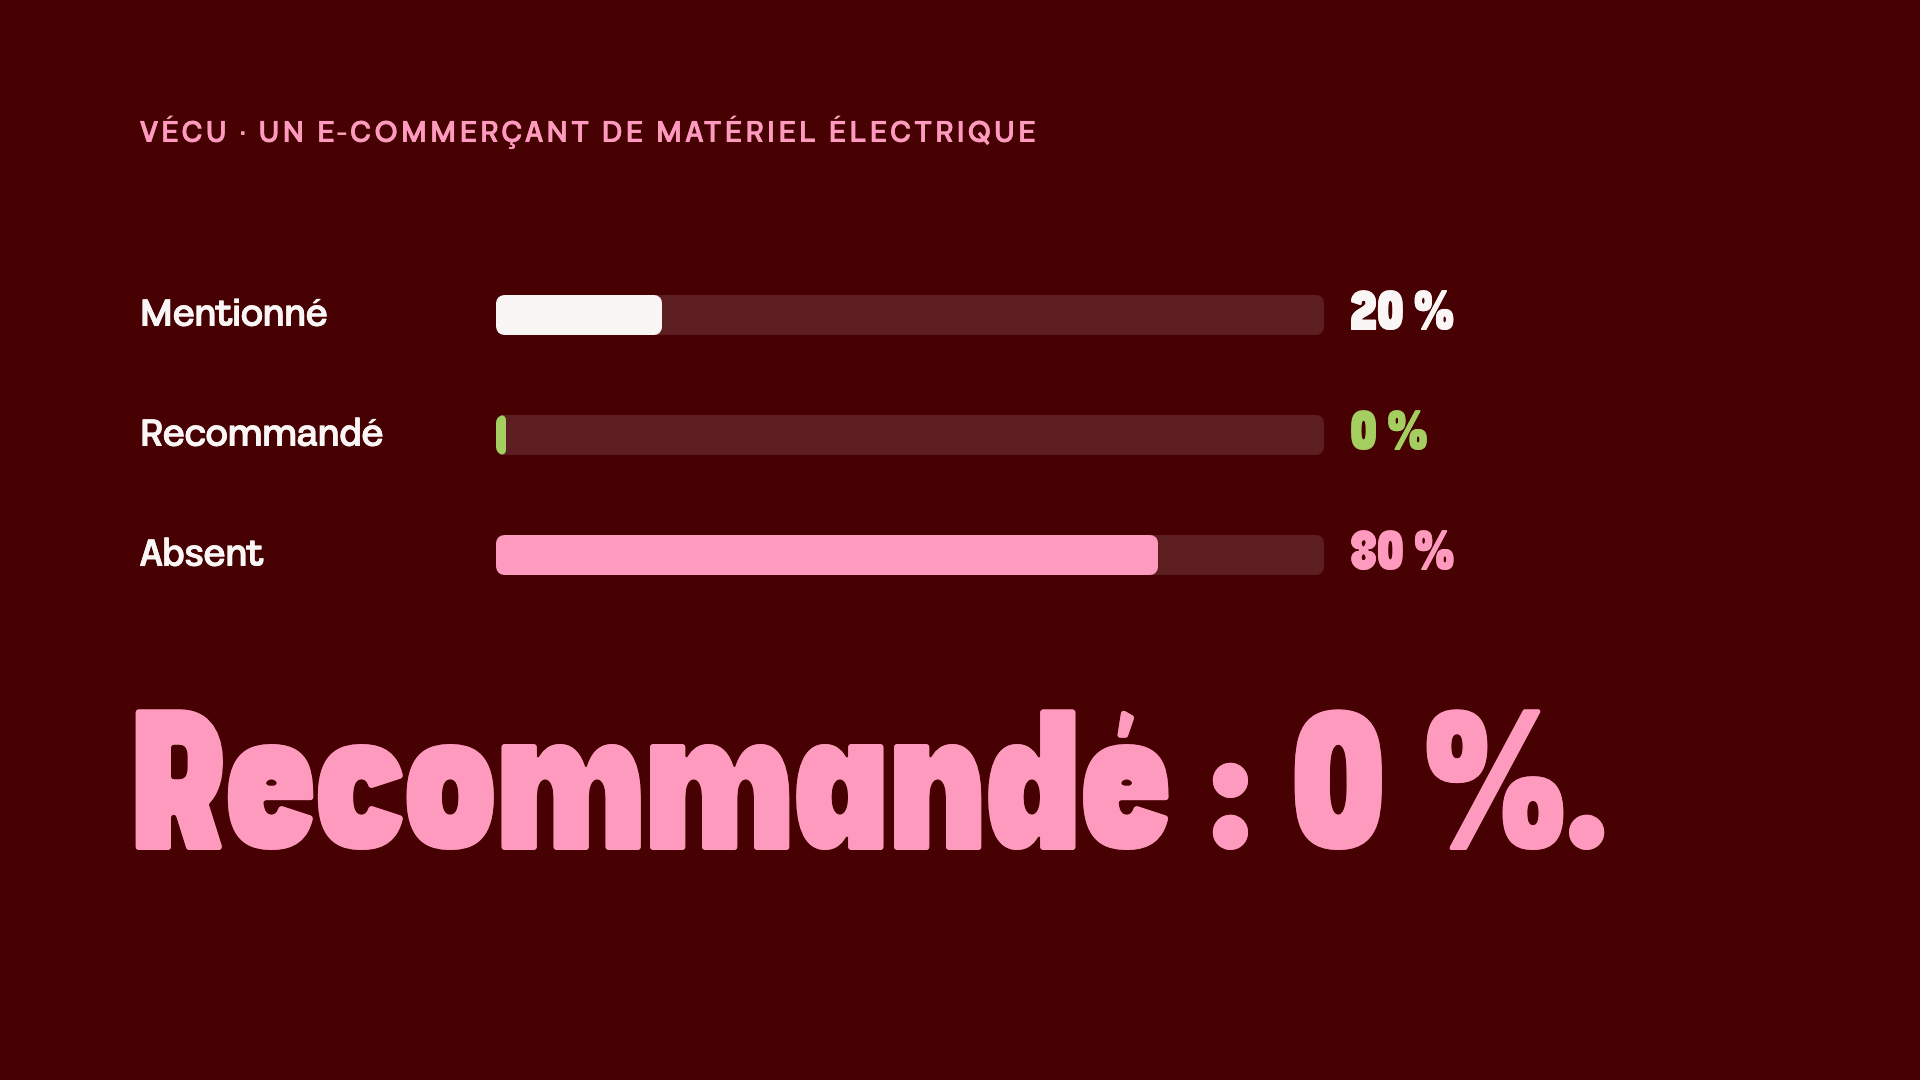
Use case · e-commerce, matériel électrique
Mentionné dans 20 % des réponses, recommandé dans 0 %, absent de 80 %. C'est le relevé qu'on voit le plus souvent en premier audit : une marque solide en SEO classique, invisible dans l'arbitrage des IA.
Si tu n'as jamais mesuré, c'est probablement ta ligne de départ aussi. La bonne nouvelle : les axes et les sources qui manquent se listent, donc se travaillent.
Non. Le SEO structure l'indexabilité et la visibilité organique ; l'audit GEO ajoute la couche IA : être compris, comparé et recommandé. Les deux se cumulent, et le chantier sémantique sert les deux : dans le cas constructeur, le trafic IA a été multiplié par 5,8 et les clics Google de la page clé sont passés de 573 à 24 895.
Oracle travaille sur ChatGPT, Claude et Gemini, qui couvrent selon Maple Labs 99 % des scénarios grand public. Les écarts entre assistants qui changeraient les enseignements sont intégrés à l'analyse. On ne vend pas de verdict séparé pour chaque moteur.
Trois semaines du cadrage à la restitution de vive voix, pour une gamme.
2 670 € en one-shot, déduits de ton premier mois si tu continues en accompagnement : le détail est sur notre grille de prix publique. Le pré-chiffrage est gratuit.
Le volet accessibilité, oui : le scanner est gratuit (21 contrôles, niveau 0-5, comparaison concurrents). Le volet conversationnel demande des milliers de conversations multi-tours sur les modèles récents : une poignée de prompts tapés dans ChatGPT ne donne pas de résultat stable. Sur les outils du marché, on a écrit pourquoi un graphique de plus ne suffit pas.
Les réponses des IA bougent avec l'actualité du marché et les mises à jour des modèles. Un re-audit par trimestre sur la gamme prioritaire est le bon rythme ; le trafic IA, lui, se suit tous les mois.
Sur ta gamme prioritaire, dans les réponses que ChatGPT donne à tes clients : si tu ne peux pas répondre avec un chiffre, personne ne mesure. Commence par le scan gratuit ; pour la photo complète, demande l'audit.
Audit GEO
Ta place dans les réponses IA
Absent, mentionné ou recommandé : on mesure, axe par axe, et on te dit quoi corriger.